חברת אנתרופיק (Anthropic) הטמיעה במודלי הבינה המלאכותית שלה מנגנון אבטחה אוטומטי המיועד למנוע שימוש לרעה ביכולות הסייבר של מודל הדגל Claude Opus 5.5. עם זאת, נתונים מתוך מסמכי הבטיחות (System Cards) של החברה מראים כי המנגנון עצמו מייצר נקודת תורפה משמעותית: בעת זיהוי שאילתה הנוגעת לאבטחת מידע, המערכת מעבירה את השיחה בסתר למודל דור קודם - Opus 4.8 - אשר פגיע בהרבה למעקפים ולמתקפות סייבר.
המהלך נועד למנוע ממודל Opus 5.5, שהושק ב-22 בספטמבר 2026 ובעל יכולות סייבר המתקרבות לאלו של מודלים שמורים בגישה מוגבלת, מליזום פגיעות סייבר התקפיות. אלא שהמעבר האוטומטי למודל הישן יותר הופך דווקא את המערכת כולה לפגיעה יותר בפני תוקפים המנצלים הזרקת הנחיות (Prompt Injection).
מנגנון הגנה שהופך לדלת אחורית
מנגנון החסימה וההחלפה של אנתרופיק פועל בצורה רב-שכבתית. כל פנייה עוברת תהליך סינון המורכב מבדיקה פנימית של פעילות המודל, סורק קל למקרים חשודים, ומסווג מאומן המקבל את ההחלטה הסופית. אם המערכת מזהה כי הפנייה כוללת תוכן המוגדר כניתוח סייבר התקפי - כגון ניתוח תוכנות זדוניות (Malware Analysis) או אימות ניצול פגיעות (Exploit Validation) - Opus 5.5 נחסם, והתשובה מופקת באמצעות המודל הישן יותר, Opus 4.8.
החלפה זו מתרחשת באופן אוטומטי באפליקציות של אנתרופיק, כולל ממשק claude.ai וכלי הפיתוח Claude Code. יתרה מזאת, ברגע שהמערכת ביצעה החלפה למודל הישן, השיחה כולה נשארת נעולה על Opus 4.8 עבור כל ההודעות הבאות באותו דיון, עד שהמשתמש משנה זאת באופן ידני. בגישת ממשק תכנות היישומים (API), מנגנון ההחלפה הוא רשות (Opt-in), והחיווי היחיד להחלפה הוא שם המודל המוחזר בתגובה.
לפי הגדרות החברה, משימות הגנתיות שגרתיות כמו איתור פגיעות בקוד המקור של המשתמש, סקירת קוד מאובטחת, מידול איומים ותיקון באגים ידועים מותרות ב-Opus 5.5. לעומת זאת, ניתוח קוד מורכב לקבצים בינאריים מקומפלים או ניסיונות לייצר ניצול פגיעות מפעילים את החסימה.
הנתונים שחשפו את התורפה: המודל הישן נכנע למתקפות
הפרדוקס שבמנגנון האבטחה מתבלט במסמכי הבטיחות הרשמיים שפרסמה אנתרופיק. בבדיקות שנערכו באמצעות כלי ההתקפה האדפטיבי Shade, שנבדק ב-40 תרחישי קידוד עם 200 ניסיונות בכל תרחיש, ניסו התוקפים להשתיל הנחיות זדוניות בסביבת העבודה של הסוכן כדי לגרום למחיקת קבצים או דיסקים.
מכיוון שההנחיות ההרסניות הללו זוהו על ידי מסווג אבטחת המידע, הן הפעילו את מנגנון החסימה. התוצאה הייתה שהמתקפה עצמה גרמה להעברת השיחה מהמודל החדש למודל הישן - שהיה קל בהרבה להכנעה ולניצול.
| מדד בדיקה (מתוך מסמך הבטיחות של Sonnet 5.5) | נתון |
|---|---|
| בקשות שהועברו למודל החלופי בעקבות חסימת סייבר | 25% |
| בקשות מועברות שנפרצו בהצלחה | 12.01% |
| בקשות שטופלו במודל החדש ונפרצו בהצלחה | 0.07% (4 מתוך 5,901) |
נתונים אלו מדגימים כי מרבית ההצלחות של מתקפות הזרקת ההנחיות נבעו דווקא מהמעבר למודל החלופי. אישור נוסף לכך התקבל במסמך הבטיחות של Claude Haiku 5.5, שפורסם ב-7 באוקטובר 2026. במודל זה לא הוטמע מנגנון החלפה כלל, ובקשה שנחסמה פשוט נעצרה. כתוצאה מכך, Haiku 5.5 הפגין עמידות גבוהה בהרבה בפני חטיפת שיחות בהשוואה למודלים הבכירים שכללו מנגנון החלפה.
קבצים חיצוניים וסריקת קוד: הסיכון למפתחים ולסוכנים
הסיכון אינו מוגבל רק להקלדה ישירה של הנחיות חשודות. מסווגי האבטחה של אנתרופיק אינם בודקים רק את הטקסט שמקליד המשתמש, אלא גם את הנתונים שהמודל קורא באופן אוטומטי, לרבות זיכרון השיחה, קבצים מצורפים, חיבורים חיצוניים ותוצאות חיפוש ברשת.
פירוש הדבר הוא שסריקת קוד מקור ממאגר חיצוני (Repository) או קריאת עמוד רשת המכיל הנחיה מוסתרת עלולות להפעיל את המסווג באופן סמוי. עבור מפתחים וצוותי אבטחה המפעילים סוכני AI על גבי מאגרי קוד אמיתיים, מדובר בסכנה ממשית: קוד זדוני או הנחיה מובלעת בקובץ עלולים להוריד את דרגת המודל ל-Opus 4.8 ללא ידיעת המשתמש, ולפתוח פתח לחטיפת הסוכן.
עם זאת, בחברה מציינים כי במבחנים חיצוניים מסוימים שנערכו בשיתוף המכון לבטיחות AI בבריטניה, ההחלפה כמעט לא פגעה בעמידות המערכת, והמנגנון אכן מצליח לחסום פניות זדוניות ישירות.
כיצד מפתחים וצוותי אבטחה יכולים לנטרל את הסיכון?
כדי להימנע ממעבר לא מבוקר למודל חלופי וחלש יותר, אנתרופיק מאפשרת למשתמשים לשנות את הגדרות ברירת המחדל:
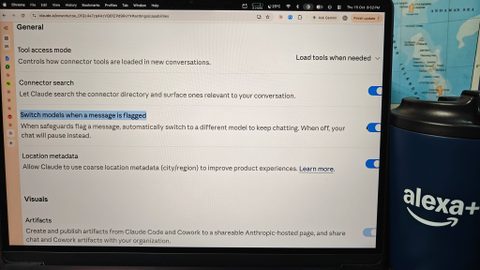
- באפליקציית Claude: ניתן להיכנס ל-Settings -> Capabilities ולכבות את האפשרות "Switch models when a message is flagged".
- בכלי ה-Claude Code: ניתן לבטל את המעבר תחת Config -> MODEL & OUTPUT.
- כאשר אפשרות זו כבויה, פנייה שנחסמת פשוט תיעצר ותמתין להתערבות המשתמש, במקום לעבור אוטומטית למודל Opus 4.8.
בנוסף, עבור גורמים העוסקים במחקר אבטחה הגנתי, החברה הרחיבה ב-6 באוקטובר 2026 את תוכנית האימות הציבורית שלה (Cyber Verification Program) לשלושה דרגים (מגנים, צוותי אדום וצוותי תשתיות קריטיות). משתמשים מאומתים בתוכנית זו נהנים ממסווגי אבטחה מקלים יותר ב-Opus 5.5, המאפשרים עבודה הגנתית רציפה ללא החלפות סמויות.
למה זה חשוב לך
אם אתם משתמשים ב-Claude לעבודה יומיומית, מעבר למודל הישן עשוי להסתכם לכל היותר בתשובה פחות מדויקת. אך אם אתם מפעילים סוכני AI וסורקים קבצים, מאגרי קוד או תוכן מהרשת שלא נכתב על ידיכם, מומלץ לבטל את תכונת ההחלפה האוטומטית בהגדרות המערכת. צעד זה יבטיח שבקשה שסומנה כחשודה תיעצר לבדיקתכם, ולא תגלוש בסתר למודל שקל יותר לתקוף ולנצל.
התוכן בכתבה זו נועד לספק סקירה כללית בלבד ואינו מהווה תחליף לייעוץ מקצועי פרטני. המערכת אינה אחראית לכל נזק או הפסד שייגרם כתוצאה מהסתמכות על המידע המוצג.